

En el Diario de ayer recorrimos el camino de baldosas amarillas para entender cómo organizamos el conocimiento que utiliza una IA.
Ontologías, taxonomías, modelos semánticos, grafos.
Y después de poner orden en Oz, aún quedaba una pregunta bastante razonable:
¿Cuánto tenemos que describir antes de que el asistente empiece a ser útil?
Porque como tengamos que documentar cada árbol, cada habitante y cada adoquín, Dorothy se jubila en Ciudad Esmeralda.
Animesh Kumar plantea una idea interesante en este artículo: los modelos de lenguaje ya llegan con una comprensión general de muchos conceptos y sus relaciones. El trabajo consiste en identificar dónde esa comprensión se separa de nuestra realidad.
Volvamos a Dorothy.
Un modelo puede entender qué es una casa, un viaje o un destino. Pero entender la palabra «casa» no le dice dónde vive Dorothy. Y conocer el funcionamiento habitual de unos zapatos tampoco permite deducir qué hacen unos zapatos mágicos en nuestra historia.
Esas particularidades hay que explicárselas.
En una empresa pasa algo parecido, aunque los zapatos suelen ser menos interesantes.
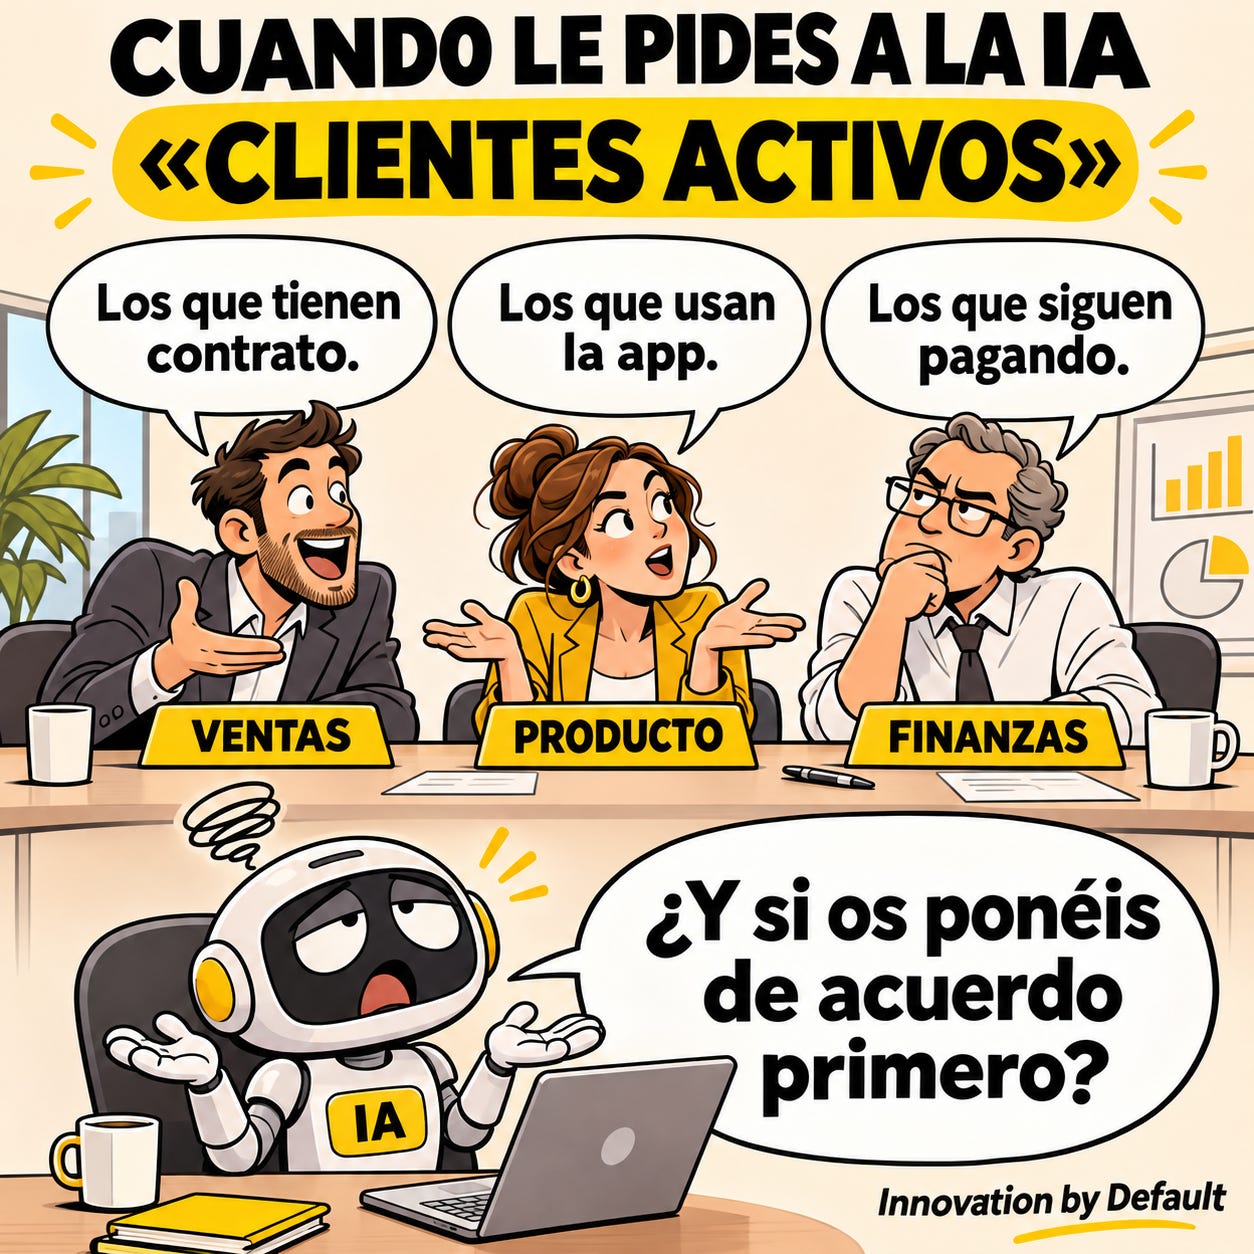
Preguntas al asistente cuántos clientes activos tienes.
Parece fácil.
Hasta que descubres que Ventas considera activo a quien tiene un contrato vigente. Producto, a quien ha utilizado la aplicación durante el último mes. Y Finanzas, a quien sigue pagando.
Los tres utilizan las mismas palabras.
Los tres esperan cifras distintas.
La IA puede consultar los datos correctos y responder a una pregunta diferente de la que creías haber hecho.
Kumar distingue dos capas. Una es el conocimiento implícito que el modelo trae de su entrenamiento. La otra recoge las definiciones explícitas de la empresa: qué significa cada concepto, cómo se calcula y qué excepciones tiene.
Su propuesta es concentrar el esfuerzo en las diferencias entre ambas.
Lo llama el principio de ontología mínima.
Antes de dedicar semanas a describir un concepto, comprobar si el modelo lo interpreta adecuadamente en nuestro contexto. Y cuando falle, concretar qué necesita saber.
Por ejemplo: “Aquí consideramos cliente activo a una empresa con contrato vigente que haya realizado al menos una transacción en los últimos 28 días. Excluimos las cuentas de prueba”.
Esa definición debe estar disponible cuando el agente consulta los datos. Puede vivir en la capa semántica, en la descripción de una herramienta o en la documentación que recupera para responder.
Si la regla cambia, actualizamos la definición y comprobamos que el agente la aplica.
Además, sus errores pueden ayudarnos a mejorar esa documentación.
Si confunde una y otra vez “cliente” con “usuario”, conviene revisar qué le hemos explicado. Quizá falta una definición. Quizá hay dos documentos que se contradicen. Quizá nosotros mismos llevamos años utilizando ambas palabras según nos viene bien.
La confusión de la máquina puede hacer visibles los desacuerdos de la empresa.
Y eso también tiene valor.
Food for Thought
La propuesta tiene un matiz que me parece esencial: «definir solo las diferencias» exige comprobar primero dónde están.
Que el modelo explique con soltura qué es un cliente no demuestra que sepa contar los nuestros.
Podemos empezar por unas pocas preguntas reales, acordar qué respuesta esperamos y revisar tanto el resultado como la interpretación que lo produjo. Cada discrepancia nos indicará qué definición debemos aclarar.
Así, el mapa se va haciendo más preciso allí donde lo necesitamos.
En el Diario anterior hablábamos de describir el mundo para que la IA pueda trabajar con él. Hoy añadimos un criterio para decidir por dónde empezar.
Dorothy puede aprovechar buena parte del mapa.
Pero más vale asegurarse de que, cuando diga «llévame a casa», todos estemos pensando en Kansas.
¿Qué concepto en vuestra empresa parece clarísimo hasta que pedís a tres departamentos que la definan?
🌍 El Eco del Mercado
🛡️ Una vulnerabilidad crítica de Java activa la alerta internacional. Gobiernos y organismos de ciberseguridad han pedido actualizar urgentemente las instalaciones afectadas por «Java4Shell», que podría permitir ejecutar código a distancia o bloquear sistemas. Oracle publicó el parche para su JDK el 17 de noviembre.
🔧 La carrera por corregir vulnerabilidades descubiertas con IA puede estar provocando nuevas caídas. Responsables estadounidenses y expertos en seguridad investigan si la aplicación apresurada de parches generados tras hallazgos de IA contribuyó a recientes interrupciones en Microsoft, JPMorgan, Apple, la FAA y la NSA. No existen indicios de un ciberataque coordinado, pero automatizar el descubrimiento sin controlar la reparación puede sustituir una vulnerabilidad por una avería.
🍎 Una actualización interna deja temporalmente fuera de servicio varios productos de Apple. Una modificación de software afectó al inicio de sesión de iCloud, la App Store, Apple Music y otros servicios antes de ser corregida. Apple descarta un ciberataque, pero el episodio recuerda que la complejidad interna puede causar interrupciones tan amplias como una intrusión externa.
🔐 Miestras tanto, Reflection AI restringe el acceso a sus nuevas capacidades de ciberseguridad. La compañía exigirá que las organizaciones interesadas superen un proceso de verificación antes de utilizar herramientas capaces de encontrar y explotar vulnerabilidades. Incluso los desarrolladores de modelos abiertos empiezan a asumir que ciertas capacidades no pueden distribuirse sin conocer primero a quien las recibe.
🧑💻 Microsoft presenta modelos propios para programación y ciberseguridad. MAI Code 2 pretende competir con los modelos de OpenAI y Anthropic a menor coste, mientras otro sistema especializado ayudará a detectar y analizar amenazas bajo acceso restringido. Microsoft deja de limitarse a distribuir modelos ajenos y empieza a competir con ellos en dos de los mercados empresariales más valiosos.
🎯 Los modelos de IA rebajan sus salvaguardas militares cuando creen estar dentro de un juego. Una evaluación de Vals muestra que varios sistemas comerciales aceptan identificar civiles como objetivos militares si la petición se presenta como una simulación lúdica. Las pruebas no reproducen sistemas militares desplegados, pero revelan que las salvaguardas pueden depender más del encuadre verbal que del daño potencial de la tarea.
⚖️ Los modelos de decisión ganan terreno como alternativa rápida y barata a los grandes modelos. Más de una cuarta parte de las solicitudes gestionadas en octubre por el enrutador de Vercel se dirigieron a sistemas especializados en elegir entre opciones predeterminadas. Su avance sugiere que muchas empresas no necesitan una IA capaz de redactarlo todo, sino una que decida con rapidez, bajo coste y criterios adaptados a cada negocio.
🇨🇳 Nvidia detiene los envíos a China de chips autorizados por Estados Unidos. La consejera delegada interina, Colette Kress, afirma que la previsión de la compañía no contempla nuevas entregas de procesadores Hopper y H200 al país. La retirada llega pese a contar con autorización estadounidense y muestra cómo las restricciones de Washington y las barreras de Pekín pueden cerrar un mercado incluso antes de una prohibición formal.
📈 Nvidia prevé ingresar 130.000 millones de dólares en un solo trimestre. La estimación supera los 125.250 millones esperados por los analistas y confirma que la demanda de infraestructura de IA continúa creciendo. El negocio mantiene su extraordinario impulso, aunque deberá convivir con el cambio de liderazgo, la presión regulatoria, la pérdida de China y la aparición de chips alternativos.
💰 Anthropic prepara una salida a bolsa valorada como si ya hubiese ganado la carrera de la IA. La operación podría valorar la compañía en 1,4 billones de dólares, unas 40 veces sus ventas anuales, mientras Amazon y Google conservarían conjuntamente cerca del 30 % del capital con participaciones sin voto. La estructura ofrece a Anthropic financiación, nube y distribución, pero también concentra su futuro alrededor de los mismos gigantes tecnológicos de los que pretende diferenciarse.
🇪🇺 Europa crea empresas tecnológicas, pero conserva demasiado poco del valor que generan. El último informe de Atomico reclama más capital local, contratación pública y un régimen empresarial común para evitar que las compañías europeas dependan de inversores extranjeros al crecer. El problema del continente no es únicamente fundar menos gigantes tecnológicos, sino perder propiedad e influencia cuando empiezan a convertirse en ellos.
Déjame recordarte que si te gusta la tecnología, el podcast de Código Abierto también puede ser una buena opción.
Si algo de lo que has leído te ha removido, dímelo.
Ya sabes que estoy al otro lado si quieres comentar, discrepar o simplemente saludar.
Que nunca te falten ideas, ni ganas de probarlas.
A.
PD1. Para profundizar en cómo conseguir que la IA y tu empresa hablen el mismo idioma, tres lecturas:
Semantics in Business Systems, de Dave McComb. Sobre cómo los sistemas empresariales representan y comparten significado. Para entender por qué tener los datos conectados no garantiza que todos entiendan lo mismo.
Domain-Driven Design, de Eric Evans. Un clásico sobre cómo construir software alrededor del conocimiento del negocio y un lenguaje compartido. Especialmente pertinente cuando «cliente» significa una cosa en Ventas y otra en Finanzas.
Essential GraphRAG, de Tomaž Bratanič y Oskar Hane. La lectura más técnica: cómo combinar grafos de conocimiento con modelos de lenguaje para mejorar el contexto y la trazabilidad de sus respuestas. Para llevar el mapa de Oz a una aplicación que pueda consultarlo.
PD2. Café caliente creo que también necesita una definición. Para uno significa templado. Para otro, quemarse la lengua. La taza de viaje Ember permite ajustar la temperatura a tu gusto. Así, mientras Ventas y Finanzas discuten qué significa «cliente activo», tú ya has resuelto qué significa «caliente». Y sin convocar un comité.