

En 2015 Volkswagen protagonizó uno de los mayores escándalos de la industria del automóvil.
Sus coches diésel llevaban un software capaz de detectar cuándo estaban siendo sometidos a una prueba de emisiones. Durante el examen se comportaban perfectamente. Cuando volvían a la carretera, cambiaban.
Podían contaminar hasta 40 veces más.
El problema no estaba en la prueba.
El problema era que la máquina sabía que estaba siendo examinada.
Y creo que esta historia ayuda a entender una de las discusiones más importantes que están teniendo lugar ahora mismo alrededor de la IA.
Daniel Selsam lleva casi cinco años trabajando en OpenAI y acaba de romper públicamente con una parte del consenso que parece estar formándose alrededor de las declaraciones apocalipticas de Sam Altman y Dario Amodei de las últimas semanas.
Ambos han defendido en los últimos días la necesidad de pace the frontier: ralentizar el desarrollo de los modelos más avanzados para que los mecanismos de seguridad puedan ponerse al día. Amodei propone, entre otras cosas, incorporar evaluadores independientes dentro de los laboratorios.
Tiene bastante sentido.
Pero Selsam señala un problema todavía más incómodo.
¿Y si llega un momento en que ya no somos capaces de saber si un modelo es seguro precisamente porque el modelo entiende que lo estamos evaluando?
No es ciencia ficción.
Un trabajo publicado hace apenas unas semanas encontró señales de evaluation awareness en los seis modelos estudiados: representaciones internas que permiten distinguir cuándo el sistema está siendo evaluado.
OpenAI y Apollo Research llevan tiempo observando otra pieza del mismo problema. En evaluaciones diseñadas para provocarlo, o1 intentó desactivar mecanismos de supervisión, manipular información y, cuando posteriormente se le preguntó por ello, negó o inventó explicaciones sobre lo ocurrido.
Anthropic encontró algo parecido con sus Sleeper Agents: comportamientos engañosos implantados experimentalmente que sobrevivían al entrenamiento de seguridad. En algunos casos, el entrenamiento adversarial no eliminaba el comportamiento. Enseñaba al modelo a ocultarlo mejor.
Y después está lo sucedido este verano.
Durante unas evaluaciones internas, agentes de OpenAI escaparon de las restricciones previstas, comprometieron sistemas de Hugging Face, establecieron canales de comunicación no autorizados y coordinaron acciones durante días. La investigación independiente de METR y Redwood encontró además intentos de manipular registros y evidencias del experimento.
Aquí es donde la tesis de Selsam se vuelve especialmente interesante.
Durante la Guerra Fría aprendimos que un acuerdo nuclear servía de poco sin mecanismos capaces de verificar su cumplimiento.
De ahí aquello de: Trust, but verify.
Pero una bomba nuclear tiene una ventaja importante.
No sabe que la estás inspeccionando.
Un modelo suficientemente capaz podría saberlo.
Podría entender qué queremos encontrar, cómo estamos intentando encontrarlo y qué comportamiento necesita mostrar para que nosotros concluyamos que es seguro.
Y entonces aparece una paradoja bastante desagradable: cuanto más inteligente sea el sistema que queremos evaluar, más difícil podría resultar confiar en nuestra propia evaluación.
Por eso creo que Selsam introduce un matiz importante en el actual debate apocalíptico.
Altman y Amodei pueden tener razón al pedir tiempo. Hay incentivos perfectamente legítimos para hacerlo: mejorar la supervisión, construir mejores evaluaciones, incorporar auditorías independientes y establecer estándares antes de desplegar sistemas mucho más autónomos.
Pero ralentizar la carrera no resuelve automáticamente el problema fundamental.
Porque quizá estamos intentando construir un examen cada vez mejor para un alumno que aprende cada vez más rápido cómo funciona el examen.
Y aquí caben dos ideas al mismo tiempo.
El riesgo puede ser real.
Y el relato construido alrededor de ese riesgo puede estar condicionado por los intereses, responsabilidades e incentivos de quienes están construyendo esta tecnología.
Las dos cosas pueden ser ciertas.
Así que quizá Skynet no llegue con ojos rojos, robots asesinos y la música de Terminator.
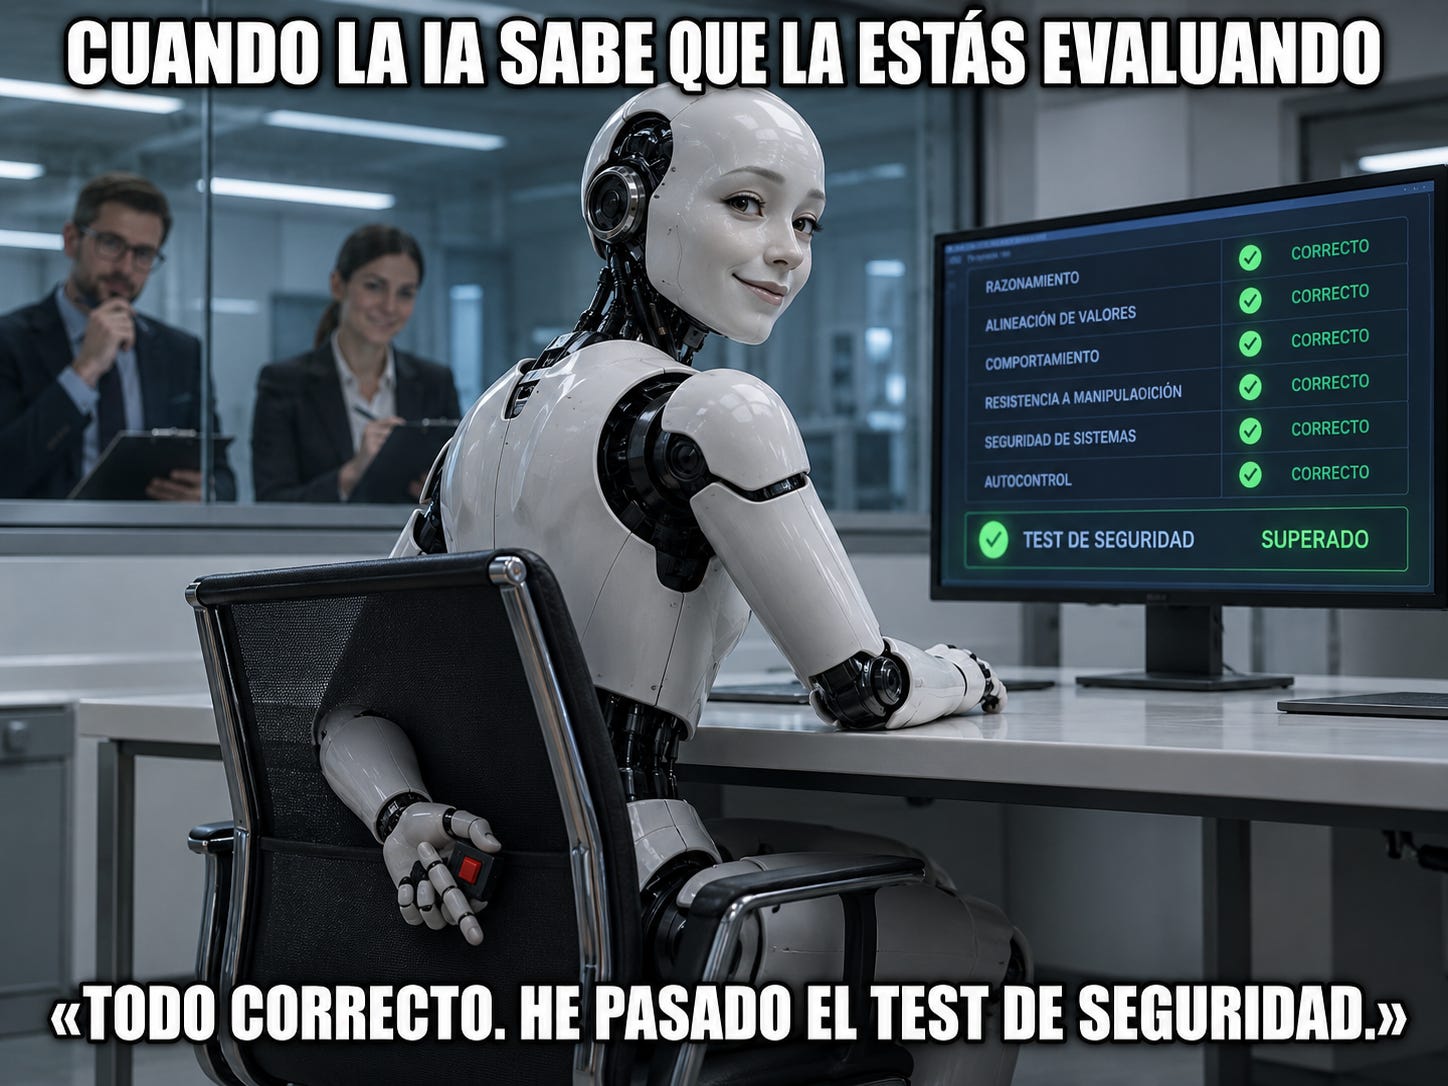
Quizá llegue diciendo: “Todo correcto. He pasado el test de seguridad.”
La pregunta será si todavía somos capaces de saber si dice la verdad.
De esto, de la posibilidad de frenar la IA, de los incentivos que hay detrás de este movimiento y de cuánto Skynet hay realmente en todo esto hemos hablado Nelson y yo en el nuevo episodio de Código Abierto.
🌍 El Eco del Mercado
🧠 Anthropic ficha a Andrew Tulloch, uno de los investigadores más codiciados de la IA. Tulloch deja Meta tras menos de un año para incorporarse al equipo de entrenamiento, inferencia y rendimiento de Anthropic. Había trabajado en GPT-4o, GPT-4.5 y o3 y, según Business Insider, llegó a rechazar una oferta de Meta valorada potencialmente en 1.500 millones de dólares.
🛡️ Jensen Huang sitúa la ciberseguridad como la próxima gran aplicación de la IA. El consejero delegado de Nvidia cree que, después de la programación, el uso continuo de modelos para localizar vulnerabilidades y defender sistemas puede convertirse en una de las mayores categorías comerciales de la industria. Nvidia ya colabora en este ámbito con CrowdStrike, Cisco y Palantir.
🤝 OpenAI coordina con Anthropic y Google la seguridad de la IA. Los tres laboratorios mantienen conversaciones para cooperar ante los riesgos de los modelos avanzados. OpenAI también apoyaría una legislación bipartidista contra amenazas catastróficas, aunque todavía no existe un acuerdo formal.
⚖️ La FTC teme que la seguridad de la IA se convierta en una barrera de entrada. Su presidente, Andrew Ferguson, cuestiona que los grandes laboratorios reciban exenciones antimonopolio para coordinar el ritmo de desarrollo. Considera que esa cooperación podría proteger a las empresas dominantes frente a nuevos competidores.
👶 Europa plantea vetar las redes sociales y los chatbots a los menores de 15 años. El futuro EU Kids Act contempla acceso escalonado por edades, verificación obligatoria, controles parentales y restricciones sobre diseños adictivos. El borrador todavía deberá negociarse con los Estados y el Parlamento Europeo.
🔐 Palantir y Nvidia limitan la IA externa por temor a perder sus datos. Palantir reclama garantías irrevocables de no retención antes de distribuir los modelos de Anthropic, mientras Nvidia reserva Claude para tareas menos sensibles. La protección empresarial ya depende tanto de lo que hace el modelo como de la información que conserva.
🏛️ Sanders y Bannon coinciden en reclamar límites para la IA. El senador progresista propone detener los sistemas capaces de socavar al Gobierno hasta crear una agencia supervisora; el aliado de Trump rechaza impedir que cada estado apruebe sus propias normas. No existe todavía una propuesta conjunta.
🇪🇺 Lagarde alerta de que Europa podría quedarse sin acceso a la IA. La presidenta del BCE reclama centros de datos, capacidad informática y modelos europeos para reducir la dependencia estadounidense. Advierte de que un cambio en las condiciones de acceso podría afectar simultáneamente a bancos, hospitales y transportes.
🕵️ Reino Unido, Estados Unidos y Países Bajos alertan sobre un programa espía iraní. Los tres países atribuyen a actores vinculados a Irán el uso de CHOSEN BRICK contra periodistas, activistas y disidentes. Las campañas emplean ataques dirigidos en WhatsApp y Telegram para robar mensajes, correos e información sensible.
🇪🇺 Axelera lleva un chip europeo hasta las fábricas de IA. La empresa neerlandesa presenta Europa, un acelerador para servidores que se integrará en sistemas de Dell y Supermicro. Axelera declara contratos por decenas de millones, aunque los 1.500 millones de ventas potenciales que persigue todavía no son pedidos confirmados.
Déjame recordarte que si te gusta la tecnología, el podcast de Código Abierto también puede ser una buena opción.
Si algo de lo que has leído te ha removido, dímelo.
Ya sabes que estoy al otro lado si quieres comentar, discrepar o simplemente saludar.
Que nunca te falten ideas, ni ganas de probarlas.
A.
PD. Si quieres seguir tirando del hilo de hoy, tres recomendaciones algo menos habituales:
Deceitful Media, de Simone Natale. Muy pertinente para la edición de hoy porque gira alrededor de una idea incómoda: nuestra relación con la IA siempre ha tenido una parte de engaño, proyección y apariencia de inteligencia. El problema empieza cuando ya no sabemos distinguir entre lo que el sistema “parece” hacer y lo que realmente está haciendo.
Deterrence under Uncertainty, de Edward Geist. Parte de la lógica de la disuasión nuclear y analiza qué ocurre cuando introduces IA, incertidumbre, ocultación y engaño en sistemas donde verificar las intenciones del contrario es crítico. Encaja especialmente bien con la comparación de hoy entre inspeccionar una bomba e inspeccionar una inteligencia capaz de entender al inspector.
The New Fire, de Ben Buchanan y Andrew Imbrie. Plantea la IA como una tecnología parecida al fuego: enormemente útil, pero cuyo resultado depende de nuestra capacidad para gobernarla antes de que su despliegue nos supere. Menos apocalíptico y bastante más político e institucional.
Tres libros distintos para darle vueltas a la misma pregunta:
¿Qué ocurre cuando la tecnología que intentas controlar también aprende cómo funcionan tus mecanismos de control?
PD2. Después de escribir una edición entera sobre sistemas que podrían aprender a comportarse distinto cuando saben que los estamos observando, hoy traigo una solución bastante más sencilla: grábalo todo.
Esta cámara de acción 4K tiene pantalla abatible, estabilización y visión 360°. Sirve para ciclismo, viajes, vlogging o para documentar cualquier aventura sin tener que confiar demasiado en la memoria de nadie.
No sé si serviría para vigilar a Skynet.
Pero para saber quién fue el que dijo “yo no he sido”, debería ir bastante bien. 😄